AIに任せるほど、
人は楽になるのか。
AIへの委任範囲は、自律時間や指示回数ではなく、独立受理された成果、人の指示・確認・修正・救済負担、そして失敗時の重さを合わせて決める。
FALSE PROXY|指示が少ない ≠ 人が楽
Anthropicの2026年6月報告では、ブログ・記事生成の中央値がChat/Coworkで13往復、Claude Codeで人の指示1回だった。これは委任の仕方が大きく違う観測であり、13倍の生産性や正確な納品を意味しない。
ACCEPTANCE GAP|Machine PASSとHuman Acceptanceを分ける
METRのSWE-bench研究では、対象サンプルでmaintainerのmerge判断が自動graderのscoreより平均約24ポイント低かった。機械的に通ったことと、現実の受け手が受理できることは同じではない。
HUMAN ACTIVE LOAD|確認・修正・救済まで数える
見るべき主指標候補は HUMAN ACTIVE LOAD PER ACCEPTED OUTPUT。最初の指示、前提準備、途中確認、最終確認、修正、失敗救済に使った人の能動時間を、独立受理された成果物数で割る。待ち時間、AI費用、総経過時間は別に記録する。
FOUR MODES|一括委任だけが自律化ではない
ONE-SHOT=成功条件が明確で独立検証が安く、失敗が可逆。
CHECKPOINTED=途中のズレが後工程で高くつくが、早期確認は安い。
COPILOT=暗黙知や人の判断が品質を定義する。
HOLD / HUMAN=検証困難、高リスク、不可逆、権限境界を越える。
DECISION ROUTER|自律性を目的ではなく結果にする
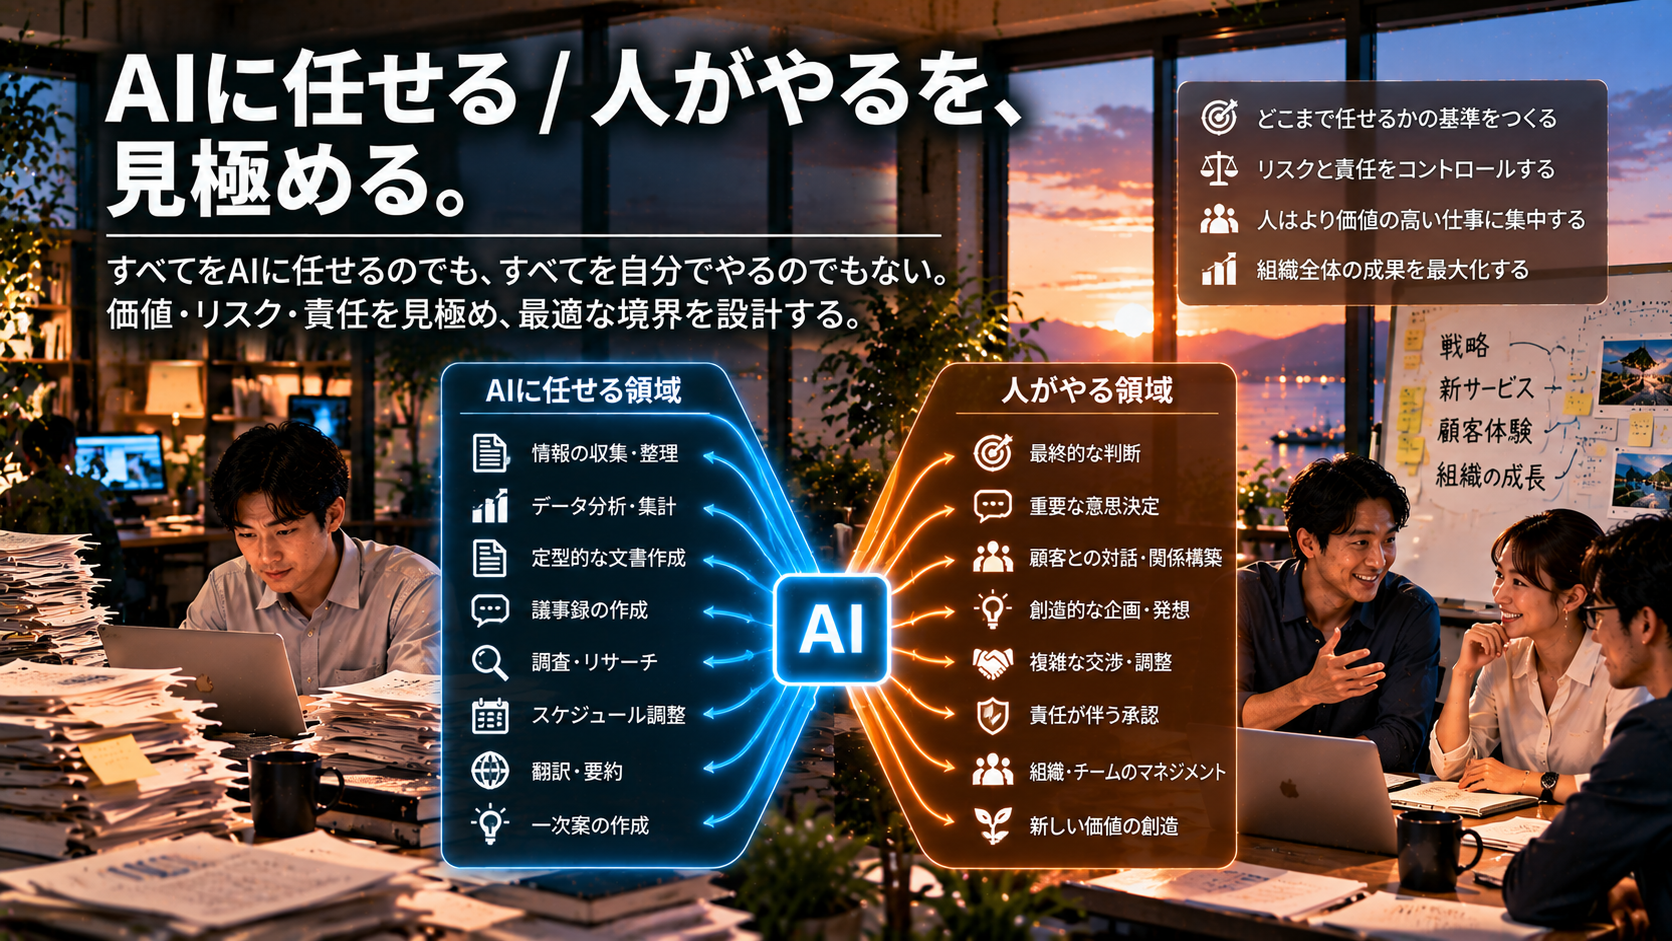
Acceptance Criteria、Independent Verify、Error Cost、Reversibility、Context Burden、Human Review Costを先に置き、その結果として委任モードを選ぶ。「どこまでAIができるか」ではなく、「どこまで任せると全体として得か」を決める。
TEST BEFORE GENERALIZE|一括と段階を同条件で比べる
FORESIGHTでの一括委任 vs 段階委任の比較は、source packet、成功条件、model/runtime、budget、stop rule、独立評価rubricを事前固定して行う。最初の1ペアは探索証拠に限定し、繰り返しFresh Taskで再現するまで一般化しない。
SOURCES|根拠へ戻れる状態にする
- Anthropic Economic Index report: Cadences2026-06-26公開。主な利用観測は2026年春〜初夏。 / 製品利用の観測。13往復対1指示を生産性倍率や品質差へ昇格させない。
- METR|Clarifying limitations of time horizon2026-01-22公開。 / time horizonの方法論上の限界。一般業務の委任可能時間そのものではない。
- METR|Many SWE-bench-Passing PRs Would Not Be Merged into Main2026-03-10公開。 / 4 maintainers・3 repositories・296 AI PRsの研究。約24ポイント差を全業務へ一般化しない。
- METR|Task Substitution and Uplift2026-05-08公開。 / 速度と価値の違いを扱う経済的整理。簡略化した仮定を含み、単一の生産性係数を与えるものではない。
公開一次資料から、委任スタイルの差、time horizonを委任可能時間へ読み替えられないこと、Machine PASSと人間受理の乖離が起こりうることは確認できる。FORESIGHT自身でONE-SHOTがCHECKPOINTEDより優れる、またはその逆であること、普遍的な閾値、全業務への最適委任方式は未証明。
次の一手へ。
このテーマを経営の前進へつなげるための関連研究です。
責任・完成条件・停止条件を確認する →